
NVIDIA hat mit Nemotron 3.5 Lightning ein offenes KI-Modell vorgestellt, das große Mengen an Aufgaben innerhalb dauerhaft laufender autonomer Agenten schnell bearbeiten soll. Das Modell verfügt insgesamt über 30 Milliarden Parameter, aktiviert bei der Verarbeitung einer Anfrage jedoch nur rund drei Milliarden davon. Dies berichtet die Webseite das-unternehmer-wissen mit einem Link zu NVIDIA.
Die Entwicklung ist vor allem für Werkzeugaufrufe, die Überprüfung von Ergebnissen, die Formatierung von Daten, Terminalaufgaben und andere wiederkehrende Prozesse vorgesehen. NVIDIA positioniert das Modell als ausführende Komponente in Agentensystemen, während größere Modelle die komplexe Planung übernehmen.
So funktioniert Nemotron 3.5 Lightning
Nemotron 3.5 Lightning basiert auf einer Mixture-of-Experts-Architektur, kurz MoE. Ein spezieller Router leitet jedes Token nur an einen Teil der internen Experten weiter. Dadurch werden bei einer Anfrage nicht alle 30 Milliarden Parameter, sondern lediglich etwa drei Milliarden aktiviert.
Dieser Ansatz reduziert den Rechenaufwand und beschleunigt die Generierung von Antworten. Gleichzeitig soll das Modell die Leistungsfähigkeit von Systemen mit einer höheren Gesamtzahl an Parametern erreichen.
Nemotron 3.5 Lightning ist das kleinste Modell der Nemotron-3-Familie. Es richtet sich an Systeme, die dauerhaft im Hintergrund arbeiten und viele ähnliche oder wiederkehrende Operationen ausführen.
NVIDIA trennt Planung und Ausführung
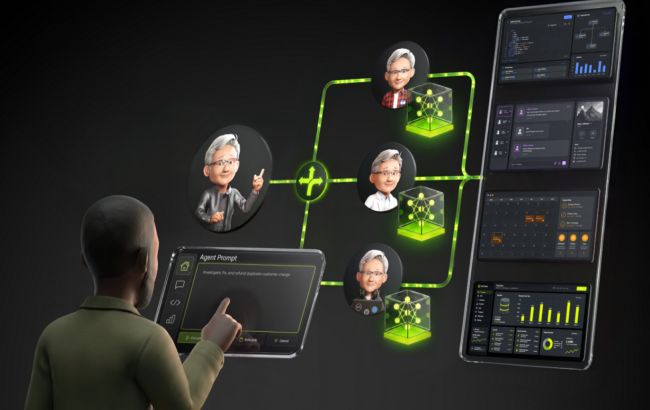
In komplexen Agentensystemen muss nicht zwangsläufig ein einziges Modell sämtliche Arbeitsschritte übernehmen. Leistungsfähige Reasoning-Modelle können für die Planung, die Auswahl geeigneter Werkzeuge und die Koordination der Prozesse zuständig sein. Kleinere Modelle führen anschließend die konkreten Anweisungen aus.
Nemotron 3.5 Lightning wurde für diese zweite Ebene entwickelt. Das Modell kann Terminalbefehle verarbeiten, Werkzeugausgaben prüfen, Informationen strukturieren und weitere Routineaufgaben erledigen, die einen erheblichen Teil des Rechen- und Tokenbudgets eines Agentensystems beanspruchen.
Zur Verteilung der Anfragen bietet NVIDIA das System NeMo Switchyard an. Es bewertet die jeweilige Aufgabe und leitet sie an das Modell weiter, das sie mit einem möglichst guten Verhältnis aus Geschwindigkeit, Genauigkeit und Kosten bearbeiten kann.
Spekulative Dekodierung beschleunigt die Ausgabe
Nemotron 3.5 Lightning unterstützt spekulative Dekodierung. Bei diesem Verfahren schlägt ein Hilfsmechanismus mehrere nachfolgende Tokens vor, die anschließend gebündelt vom Hauptmodell überprüft werden.
NVIDIA integrierte während des Vortrainings die sogenannte Multi-Token-Prediction-Funktion, kurz MTP. Danach folgte eine gesonderte Trainingsphase, um die Genauigkeit dieser Vorhersagen zu erhöhen.
Zusätzlich stehen zwei Draft-Modelle zur Verfügung:
- DSpark ist für DGX Spark sowie Rechenzentrumslasten mit geringer Parallelität vorgesehen.
- DFlash dient zur Beschleunigung der Inferenz und kann in weiteren Hardwarekonfigurationen eingesetzt werden.
Welches Verfahren am besten geeignet ist, hängt von der Zahl gleichzeitiger Anfragen, der verwendeten Hardware und der jeweiligen Arbeitslast ab.
Das Modell ist in BF16 und NVFP4 verfügbar
NVIDIA veröffentlicht Nemotron 3.5 Lightning im Standardformat BF16 und als quantisierte NVFP4-Version. Durch die Quantisierung sinken der Speicherbedarf und die benötigte Rechenleistung. Das erleichtert den Betrieb auf kompakterer Hardware.
Für die Verarbeitung im NVFP4-Format werden spezielle Rechenkerne genutzt, die NVIDIA-Grafikprozessoren der Architekturen Blackwell, Hopper und Ampere unterstützen. Derselbe Checkpoint kann sowohl in Rechenzentren als auch auf einem lokalen DGX-Spark-System eingesetzt werden.
Nach Angaben des Unternehmens lässt sich Nemotron 3.5 Lightning außerdem auf Jetson-Systemen und Computern mit einer GeForce RTX 5090 betreiben. Unterstützt werden verbreitete Werkzeuge für lokale KI-Anwendungen, darunter Ollama, LM Studio, llama.cpp und Unsloth.
Nemotron 3.5 Lightning lässt sich anpassen
Entwickler können das Modell mit LoRA oder vollständigem Supervised Fine-Tuning für bestimmte Aufgaben optimieren. NVIDIA stellt dafür NeMo Automodel und NeMo Megatron Bridge bereit.
Reinforcement Learning, Evaluationen und umgebungsbasiertes Training lassen sich mit NeMo RL und NeMo Gym durchführen. Zusammen mit dem Modell veröffentlichte das Unternehmen den Datensatz Nemotron-RL Agentic Terminal Pivot. Er wurde zum Training bestimmter Fähigkeiten von Programmieragenten verwendet.
NVIDIA stellt die Modellgewichte, Trainingsdaten und Trainingsrezepte unter der OpenMDW-1.1-Lizenz zur Verfügung. Dadurch kann Nemotron 3.5 Lightning an Unternehmensprozesse, spezialisierte Software und lokale Agentenplattformen angepasst werden.
Vergleich mit Qwen3.6 35B
Laut den Ergebnissen des Artificial Analysis Intelligence Index liegt Nemotron 3.5 Lightning bei kleineren offenen Modellen auf der Pareto-Grenze. Die Bewertung berücksichtigt sowohl die Genauigkeit als auch die Ausgabegeschwindigkeit.
Im PinchBench erreichte das Modell eine Genauigkeit von 86 Prozent. Für die Bearbeitung von 10.000 Agentenaufgaben benötigte es den Angaben zufolge rund 30 Prozent weniger Zeit als Qwen3.6 35B bei vergleichbarer Genauigkeit.
NVIDIA spricht außerdem von einer Ausgabegeschwindigkeit, die bis zu viermal höher als bei einigen ähnlich großen Modellen ausfallen kann. Die tatsächliche Leistung hängt von der Hardwarekonfiguration, dem Parallelitätsgrad und dem verwendeten Dekodierungsverfahren ab.
Wo Nemotron 3.5 Lightning verfügbar sein soll
Das Modell wird in verschiedene Frameworks und Plattformen zur Entwicklung von KI-Agenten integriert. Zu den genannten Partnern gehören LangChain, OpenHands, Cline, OpenCode, Kilo Code, Hermes Agent und Factory AI.
Der Betrieb über Cloud-Infrastrukturen soll unter anderem durch Amazon SageMaker JumpStart, Google Cloud, Microsoft Foundry und Oracle Cloud Infrastructure unterstützt werden. Auch Anbieter wie CoreWeave, DeepInfra, Fireworks AI, Together AI, Nebius und Baseten wollen entsprechende Hostingangebote bereitstellen.
Nemotron 3.5 Lightning kann in einer interaktiven NVIDIA-Umgebung oder über OpenRouter getestet werden. Die Modellgewichte für lokale Installationen und individuelle Anpassungen stehen auf Plattformen für die Verteilung offener KI-Modelle bereit.
